






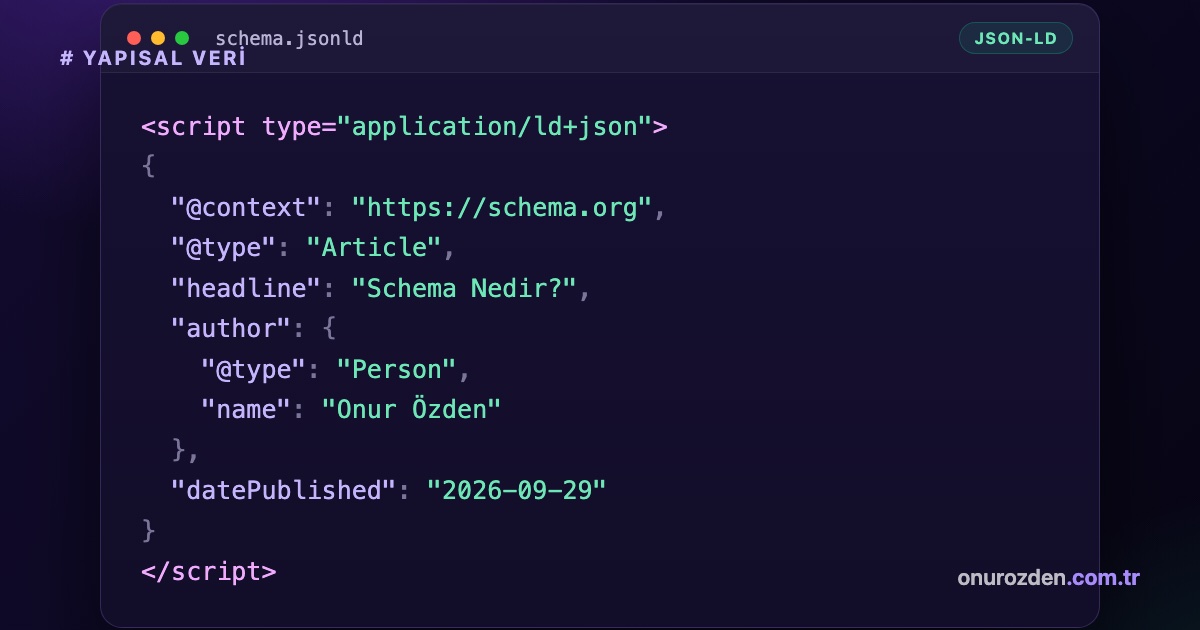
स्कीमा क्या है? प्रश्न का सबसे स्पष्ट उत्तर है; वे संरचित डेटा मार्कअप मानक हैं जो खोज इंजनों को आपकी वेबसाइट की सामग्री को अधिक आसानी से समझने, समृद्ध परिणाम देने और कृत्रिम बुद्धिमत्ता इंजनों को आपकी साइट से सटीक जानकारी निकालने में सक्षम बनाते हैं। इन मानकों के लिए धन्यवाद, वेब पेजों पर सादा पाठ सार्थक डेटा में बदल जाता है जिसे खोज इंजन बॉट सीधे व्याख्या कर सकते हैं। आपके द्वारा अपनी वेबसाइट पर जोड़ा गया प्रत्येक संरचित डेटा टैग न केवल खोज परिणामों में आपकी साइट की दृश्यता बढ़ाता है, बल्कि नई पीढ़ी के कृत्रिम बुद्धिमत्ता खोज इंजनों में एक स्रोत के रूप में उद्धृत होने की आपकी संभावनाओं को भी सीधे बढ़ाता है।
स्कीमा संरचित डेटा क्या है और यह कैसे काम करता है?
स्कीमा संरचित डेटा एक सामान्य भाषा में वेब पेजों पर जानकारी को लेबल करने की एक प्रणाली है जिसे खोज इंजन समझ सकते हैं। यह प्रणाली खोज इंजन बॉट को पृष्ठ सामग्री को क्रॉल करते समय अनुमान लगाने के बजाय सीधे सटीक जानकारी तक पहुंचने की अनुमति देती है। उदाहरण के लिए, आइए एक ई-कॉमर्स साइट पर बेचे जाने वाले वायरलेस हेडसेट उत्पाद को लें। जब खोज इंजन बॉट संरचित डेटा के बिना एक मानक पृष्ठ को क्रॉल करते हैं, तो उन्हें यह समझने में कठिनाई हो सकती है कि संख्या "599" एक मूल्य, स्टॉक में मात्रा या मॉडल संख्या है या नहीं। जब स्कीमा मार्कअप लागू किया जाता है, तो यह संख्या सीधे मूल्य टैग से पहचानी जाती है। इस प्रकार, उत्पाद की कीमत, स्टॉक स्थिति और उपयोगकर्ता रेटिंग जैसी महत्वपूर्ण जानकारी सीधे खोज परिणामों में उपयोगकर्ताओं को दिखाई जाती है। इससे खोज परिणामों में आपकी क्लिक-थ्रू दर उल्लेखनीय रूप से बढ़ जाती है।
आर्टिफिशियल इंटेलिजेंस सर्च इंजन के लिए स्कीमा क्यों महत्वपूर्ण है?
पारंपरिक इंडेक्स क्रॉलर के विपरीत, आर्टिफिशियल इंटेलिजेंस सर्च इंजन को स्कीमा डेटा की अधिक आवश्यकता होती है क्योंकि वे सीधे जानकारी को संश्लेषित करते हैं और इसे उपयोगकर्ता के सामने प्रस्तुत करते हैं। Perplexity, ChatGPT और Google Gemini जैसे सिस्टम वेबसाइटों से डेटा पुनर्प्राप्त करते समय संरचनात्मक रूप से टैग की गई जानकारी को प्राथमिक स्रोत मानते हैं। आपकी साइट पर संरचित डेटा का उपयोग करने से कृत्रिम बुद्धिमत्ता इंजनों के लिए आपको सही ढंग से समझना और उनके उत्तरों में प्रत्यक्ष स्रोतों का हवाला देना आसान हो जाता है। यह आधुनिक खोज इंजन अनुकूलन का सबसे महत्वपूर्ण हिस्सा है। कृत्रिम बुद्धिमत्ता एसईओ यह उसकी रणनीतियों का आधार भी बनता है। आप नीचे दी गई तालिका में पारंपरिक खोज इंजनों से कृत्रिम बुद्धिमत्ता इंजनों के अंतर और संरचित डेटा के प्रति उनके दृष्टिकोण की जांच कर सकते हैं।
| सुविधा | पारंपरिक खोज इंजन | कृत्रिम बुद्धिमत्ता खोज इंजन (GEO) |
|---|---|---|
| डेटा पढ़ने की विधि | कीवर्ड मिलान और लिंक मानचित्र | सिमेंटिक संदर्भ और संरचित डेटा विश्लेषण |
| स्कीमा प्राथमिकता | समृद्ध परिणाम उत्पन्न करने के लिए (रिच स्निपेट्स) | प्रत्यक्ष प्रतिक्रिया स्रोत और सूचना संश्लेषण के लिए |
| व्यवहार का हवाला देते हुए | वेबसाइटों को रैंकिंग सूची के रूप में प्रस्तुत करता है | स्रोत लिंक सीधे वाक्य में देता है |
जैसा कि तालिका में देखा गया है, नई पीढ़ी के खोज इंजनों में दिखाई देने के लिए संरचित डेटा की संपूर्ण संरचना महत्वपूर्ण है। इस विषय पर अधिक गहन जानकारी प्राप्त करने के लिए Perplexity क्या है? व्यवसायों के लिए GEO क्यों महत्वपूर्ण है? आप शीर्षक वाली हमारी मार्गदर्शिका की समीक्षा भी कर सकते हैं।
सर्वाधिक प्रयुक्त स्कीमा प्रकार क्या हैं?
आपके द्वारा उपयोग किए जाने वाले संरचित डेटा टेम्प्लेट आपकी वेबसाइट के प्रकार और आपके द्वारा ऑफ़र की जाने वाली सामग्री के आधार पर भिन्न होते हैं। सही पृष्ठ पर सही टेम्पलेट का उपयोग यह सुनिश्चित करता है कि खोज इंजन आपकी साइट को सही ढंग से वर्गीकृत करते हैं। सबसे अधिक उपयोग किए जाने वाले पांच मुख्य प्रकार के संरचित डेटा हैं:
- आलेख स्कीमा: इसका उपयोग ब्लॉग पोस्ट, समाचार और गाइड सामग्री के लिए किया जाता है। लेखक का नाम, प्रकाशन दिनांक और शीर्षक जैसी जानकारी स्पष्ट करता है।
- उत्पाद स्कीमा: ई-कॉमर्स पेजों पर मूल्य, स्टॉक स्थिति, मुद्रा और उपयोगकर्ता समीक्षाओं को चिह्नित करना पसंद किया जाता है।
- स्थानीय व्यवसाय योजना: यह भौतिक दुकानों या कार्यालयों वाले व्यवसायों के पते, टेलीफोन, काम के घंटे और स्थान की जानकारी को परिभाषित करता है।
- FAQपेज (अक्सर पूछे जाने वाले प्रश्न) स्कीम: यह आपको खोज इंजनों के लिए एक पृष्ठ पर प्रश्न और सीधे उत्तर प्रस्तुत करके SERP पर एक बड़े क्षेत्र को कवर करने की अनुमति देता है।
- संगठन योजना: इसका उपयोग आपके ब्रांड के लोगो, सोशल मीडिया अकाउंट और आधिकारिक संपर्क जानकारी को खोज इंजन में पेश करने के लिए किया जाता है।
JSON-LD फ़ॉर्मेट में चरण दर चरण स्कीमा कैसे बनाएं?
JSON-LD एक JavaScript आधारित संरचित डेटा प्रारूप है जिसे Google द्वारा सबसे अधिक अनुशंसित किया जाता है और इसे HTML कोड में कहीं भी आसानी से रखा जा सकता है। यह प्रारूप पृष्ठ डिज़ाइन को बाधित किए बिना पृष्ठभूमि में साफ़-साफ़ चलता है। नीचे एक स्थानीय व्यवसाय के लिए JSON-LD कोड ब्लॉक का एक उदाहरण दिया गया है:
{"@context": "https://schema.org","@type": "LocalBusiness","name": "Onur Özden Web Çözümleri","image": "https://www.onurozden.com.tr/logo.png","telephone": "+905000000000","address": {"@type": "PostalAddress","streetAddress": "Hürriyet Mahallesi No 10","addressLocality": "İzmir","postalCode": "35000","addressCountry": "TR"}}उपरोक्त कोड ब्लॉक की पहली पंक्ति इंगित करती है कि schema.org मानकों का उपयोग किया जाएगा। दूसरी पंक्ति में LocalBusiness कथन यह पहचानता है कि यह स्कीमा एक स्थानीय व्यवसाय से संबंधित है। नाम रेखा व्यवसाय का आधिकारिक नाम दिखाती है, छवि रेखा ब्रांड लोगो का पता दिखाती है। जबकि टेलीफ़ोन फ़ील्ड में सीधे खोजने योग्य फ़ोन नंबर होता है, पता ब्लॉक श्रेणीबद्ध रूप से खोज इंजनों के लिए व्यवसाय का आधिकारिक डाक पता प्रस्तुत करता है।
साइट पर बनाए गए स्कीमा कोड कैसे जोड़ें?
आप अपनी साइट के बुनियादी ढांचे के आधार पर, अपनी वेबसाइट पर बनाए गए JSON-LD कोड को जोड़ने के लिए विभिन्न तरीकों का पालन कर सकते हैं। WordPress आधारित साइटों पर, यह प्रक्रिया प्लगइन्स के माध्यम से काफी आसानी से की जाती है। विशेष सॉफ़्टवेयर वाली वेबसाइटों में, कोड को सीधे स्रोत फ़ाइलों में एकीकृत किया जाना चाहिए। आप इन तीन चरणों से कोड जोड़ने की प्रक्रिया पूरी कर सकते हैं:
- थीम फ़ाइलों में जोड़ा जा रहा है: आप अपना JSON-LD कोड अपनी साइट की हेडर.php फ़ाइल में हेड टैग के बीच या फ़ुटर.php फ़ाइल में रख सकते हैं।
- प्लगइन उपयोग: यदि आप WordPress का उपयोग करते हैं, तो आप Rank Math या Yoast एसईओ जैसे लोकप्रिय अनुकूलन प्लगइन्स के माध्यम से किसी भी कोडिंग ज्ञान की आवश्यकता के बिना अपना संरचित डेटा बना सकते हैं और पृष्ठों पर असाइन कर सकते हैं।
- Google Tag Manager एकीकरण: यदि आप कोड को सीधे साइट स्रोत कोड में नहीं जोड़ना चाहते हैं, तो आप Google Tag Manager पर एक कस्टम HTML टैग बनाकर अपने स्कीमा को ट्रिगर कर सकते हैं।
संरचित डेटा (स्कीमा) ऑडिटिंग और परीक्षण कैसे करें?
आपको यह सत्यापित करने के लिए नियमित ऑडिट करना चाहिए कि आप अपनी साइट पर जो संरचित डेटा जोड़ते हैं, वह खोज इंजन द्वारा सही ढंग से पढ़ा जा रहा है या नहीं। जो कोड विकृत हैं या जिनमें गायब कोष्ठक हैं, उन्हें खोज इंजन द्वारा अनदेखा कर दिया जाएगा। हमने इस ऑडिट को करने के लिए एक निःशुल्क दस्तावेज़ तैयार किया है। स्ट्रक्चर्ड डेटा (Schema) ऑडिट आप टूल का उपयोग कर सकते हैं. बस उस पृष्ठ का पता दर्ज करें जिसे आप हमारे टूल में जांचना चाहते हैं या सीधे आपके द्वारा बनाया गया JSON-LD कोड दर्ज करें। कोड की वैधता का विश्लेषण सेकंड के भीतर किया जाता है, और कोई भी लापता फ़ील्ड और सिंटैक्स त्रुटियां एक रिपोर्ट के रूप में आपकी स्क्रीन पर दिखाई देती हैं। अपने कोड का परीक्षण करते समय, आप इस तीन-चरणीय जाँच प्रक्रिया का पालन कर सकते हैं:
- सिंटैक्स जाँच: सुनिश्चित करें कि कोड ब्लॉक में सभी घुंघराले ब्रैकेट और अल्पविराम सही ढंग से रखे गए हैं।
- रिच परिणाम संगतता: Google रिच परिणाम परीक्षण टूल का उपयोग करके जांचें कि स्कीमा खोज परिणामों में प्रदर्शित होने के योग्य है या नहीं।
- लाइव यूआरएल विश्लेषण: एक बार पृष्ठ लाइव हो जाने पर, Search Console के माध्यम से सत्यापित करें कि खोज इंजन बॉट त्रुटियों के बिना कोड को क्रॉल कर सकते हैं।
स्कीमा अनुप्रयोगों में की जाने वाली सामान्य गलतियाँ क्या हैं?
संरचित डेटा जोड़ते समय की गई तकनीकी और तार्किक गलतियाँ खोज इंजनों की नज़र में आपकी साइट की विश्वसनीयता को नुकसान पहुँचा सकती हैं। सबसे आम त्रुटियाँ और उनके समाधान इस प्रकार हैं:
- अदृश्य सामग्री को फ़्लैग करें: स्कीमा कोड में सीएसएस के साथ छिपा हुआ पाठ जोड़ना Google नीतियों के विरुद्ध है जिसे आगंतुक पृष्ठ पर नहीं पढ़ सकते हैं। समाधान के रूप में, केवल वही जानकारी चिह्नित करें जो पृष्ठ पर सक्रिय रूप से दिखाई देती है।
- गलत स्कीमा प्रकार चुनना: असंगत मिलान, जैसे ब्लॉग पोस्ट में उत्पाद स्कीमा जोड़ना, खोज इंजनों को भ्रमित करता है। समाधान के लिए, प्रत्येक पृष्ठ प्रकार के लिए केवल उस पृष्ठ के उद्देश्य के लिए उपयुक्त स्कीमा को परिभाषित करें।
- सिंटैक्स त्रुटियाँ: JSON-LD कोड में भूले हुए अल्पविराम या खुले घुंघराले ब्रेस के कारण पूरा कोड अमान्य हो जाएगा। समाधान के लिए, अपने कोड को प्रकाशित करने से पहले परीक्षण टूल के माध्यम से पारित करना सुनिश्चित करें।
उचित संरचित डेटा सेटअप के लिए चेकलिस्ट
अपना संरचित डेटा प्रकाशित करने से पहले नीचे दी गई तकनीकी जांच सूची की समीक्षा करने से संभावित त्रुटियों को रोका जा सकेगा। जब आप इन वस्तुओं को पूरी तरह से पूरा कर लेंगे, तो आपके पास एक स्वस्थ एकीकरण होगा:
- सुनिश्चित करें कि JSON-LD कोड में कोई तुर्की वर्ण समस्या नहीं है।
- जांचें कि आपके द्वारा चुना गया स्कीमा प्रकार वर्तमान schema.org लाइब्रेरी में शामिल है।
- सत्यापित करें कि स्कीमा में URL पते टूटे नहीं हैं और HTTPS प्रोटोकॉल से प्रारंभ करें।
- Google Search Console पर रिच रिजल्ट रिपोर्ट का नियमित रूप से पालन करें।
अपनी वेबसाइट के तकनीकी बुनियादी ढांचे को मजबूत करने और खोज इंजन के साथ पूर्ण अनुकूलता प्राप्त करने के लिए एक पेशेवर दृष्टिकोण की आवश्यकता होती है। आपकी साइट की दृश्यता को अधिकतम करने के लिए हमारी विशेषज्ञ टीम से व्यावसायिक सहायता। कृत्रिम बुद्धिमत्ता एसईओ आप सेवा प्राप्त कर सकते हैं.
क्या स्कीमा कोड वेबसाइट को धीमा कर देते हैं?
नहीं, JSON-LD प्रारूप में स्कीमा कोड आपकी वेबसाइट की लोडिंग गति पर नकारात्मक प्रभाव नहीं डालते हैं क्योंकि वे अतुल्यकालिक रूप से लोड होते हैं।
क्या स्कीमा जोड़ने से निश्चित रूप से खोज परिणामों में समृद्ध स्निपेट उत्पन्न होते हैं?
संरचित डेटा जोड़ने से समृद्ध परिणाम की संभावना बहुत बढ़ जाती है, लेकिन इसकी गारंटी नहीं है कि इसे निश्चितता के साथ दिखाया जाएगा; अंतिम निर्णय Google एल्गोरिदम का है।
क्या एक ही पृष्ठ पर एक से अधिक स्कीमा प्रकार का उपयोग किया जा सकता है?
हाँ, एक पृष्ठ पर एक से अधिक संगत स्कीमा प्रकार का उपयोग किया जा सकता है, जैसे कि आलेख और FAQPage स्कीमा।
क्या Google के अलावा अन्य कृत्रिम बुद्धिमत्ता खोज इंजन भी स्कीमा डेटा पढ़ते हैं?
हां, एआई-आधारित सिस्टम जैसे Perplexity और ChatGPT वेब पेजों पर जानकारी को समझने और स्रोत करने के लिए स्कीमा डेटा को सक्रिय रूप से पढ़ते हैं।
क्या WordPress साइटों पर स्कीमा जोड़ने के लिए प्लगइन का उपयोग करना अनिवार्य है?
यह अनिवार्य नहीं है; आप अपने थीम के शीर्षलेख या पादलेख फ़ाइलों में अपने द्वारा बनाए गए JSON-LD कोड को मैन्युअल रूप से जोड़कर भी प्रक्रिया को पूरा कर सकते हैं।